Transformer 是一种基于注意力机制的神经网络架构。
为了理解这种神经网络的设计理念、网络结构和工作原理,我们将围绕两个任务:文本翻译(Text Translation)和图像描述(Image Captioning)进行讲述。

任务一:文本翻译
英文:Peach looks absolutely radiant.
中文:Peach 看起来光彩照人。
任务二:图像描述
Peach is wearing a black face mask and dark blue overalls.(Peach 戴着黑色口罩,穿着深蓝色背带裤。)
设计理念
Core Concept
2017 年,Transformer 在论文 Attention Is All You Need 中被提出。与传统递归神经网络(Recurrent Neural Network,RNN)依次处理序列不同,Transformer 利用注意力机制(Attention Mechanism),让不同位置的信息直接建立联系。
在文本翻译中,模型不仅需要理解 Peach、looks、absolutely 和 radiant 各自的含义,还需要理解例如 absolutely 对 radiant 的程度修饰,以及整句话所表达的状态。
在图像描述中,模型则需要观察 Peach 的帽子、眼镜、黑色口罩和深蓝色背带裤,并理解这些视觉特征属于同一个人物,从而生成准确的描述。
虽然一个任务在处理语言,另一个任务在处理图像,但两者都需要建立不同信息之间的关联。
划重点:Transformer 通过注意力机制建立信息依赖关系,实现上下文理解与序列预测。
网络结构
Network Architecture
经典 Transformer 神经网络采用编码器 — 解码器(Encoder – Decoder)结构。
编码器(Encoder)负责理解输入信息,解码器(Decoder)则利用编码器的输出和此前已经生成的 Token,逐步预测新的 Token。
在文本翻译中,编码器接收 Peach looks absolutely radiant.,形成英文上下文表示;解码器根据这些信息生成“ Peach 看起来光彩照人。 ”的中文翻译。
在训练和推理时,解码器的输入来源不同,但都遵循同一个原则:预测下一个 Token 时,只能使用此前的目标 Token,不能提前看到正在预测的正确答案。详细看英文:Peach looks absolutely radiant. 正确译文:Peach 看起来光彩照人。
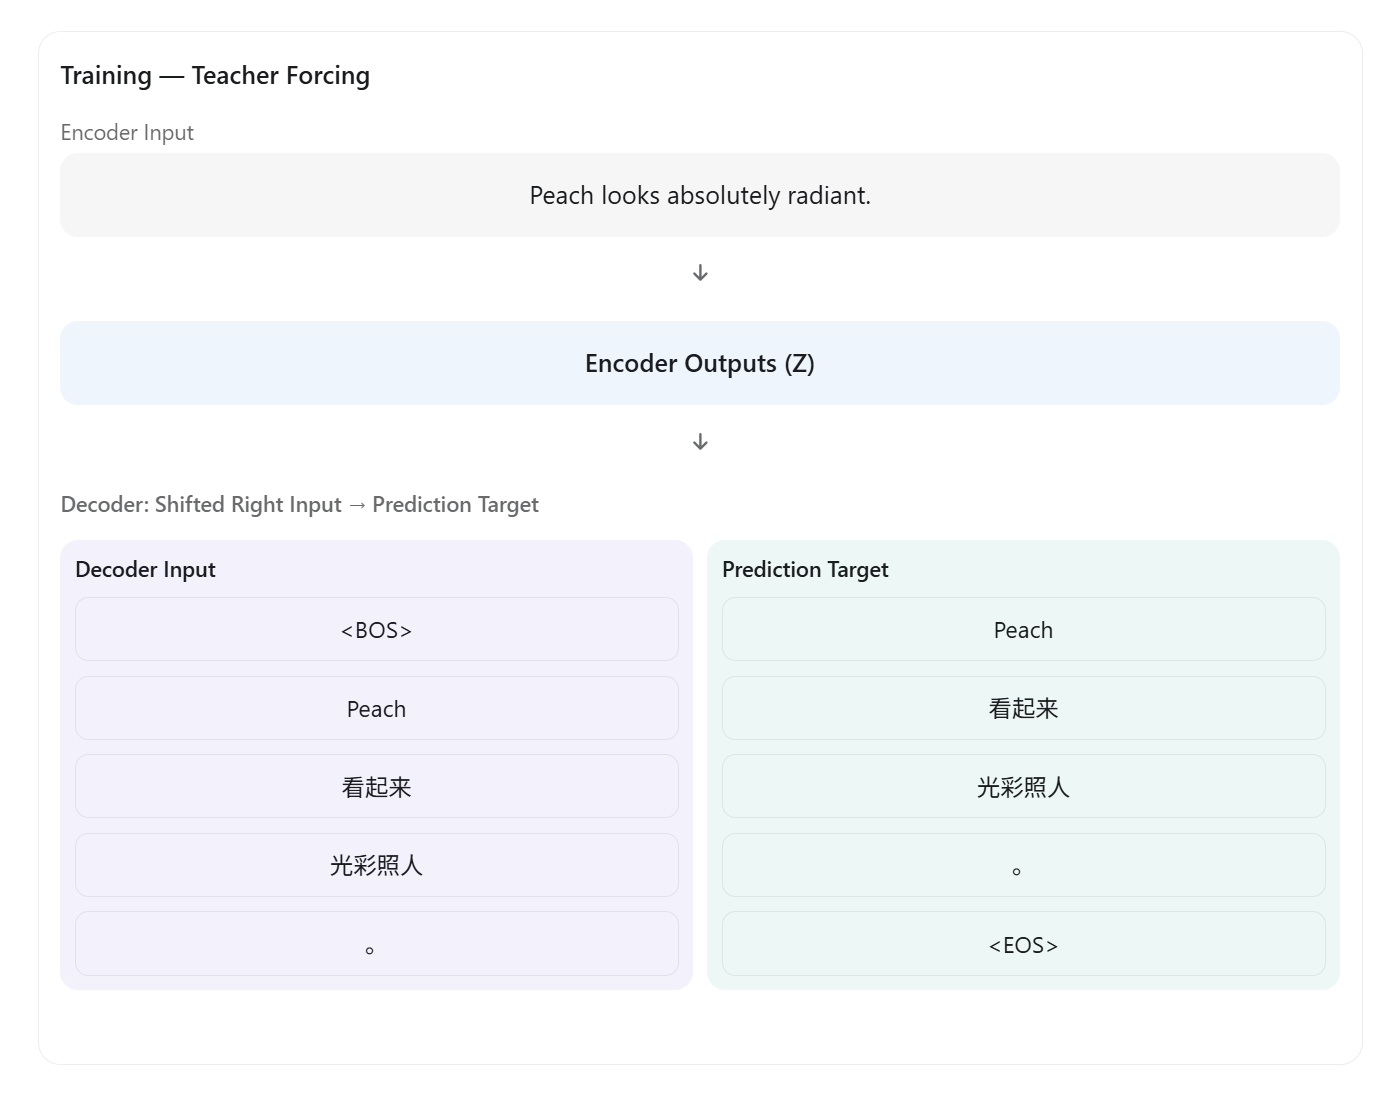 在训练时,我们已经知道正确译文。为了让 Transformer 学会翻译,采用教师强制(Teacher Forcing)方法,将正确译文右移一位,作为解码器输入。
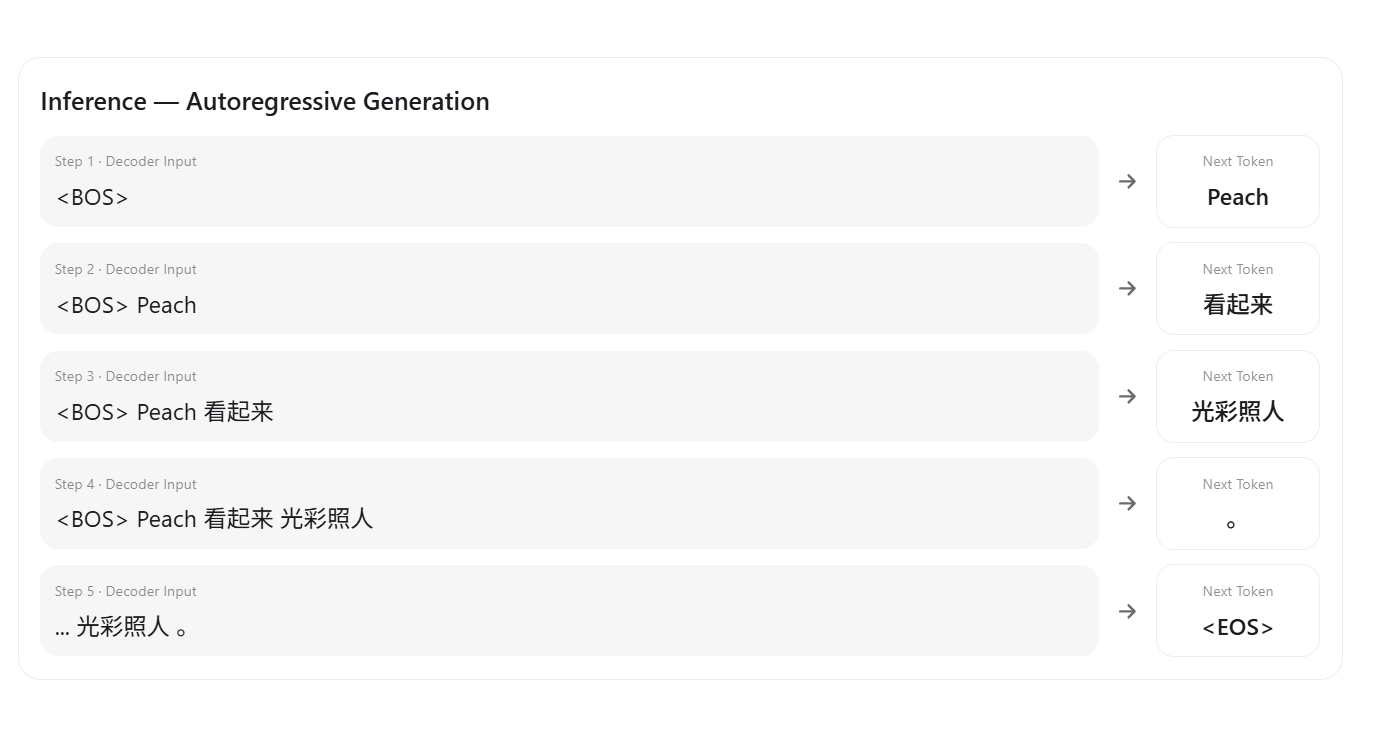 在推理时:解码器并不知道正确译文,例如当训练完成后,用户输入一句新的英文:Peach looks absolutely radiant. 此时并没有提供中文译文,解码器只能从 BOS 开始,根据编码器输出逐步生成。每预测出一个 Token,就把它追加到解码器输入序列中,再预测下一个 Token,直到生成 EOS。
这里有一个重要区别:训练时解码器使用此前的正确目标 Token,而推理时使用此前由模型自己生成的 Token。

在图像描述中,视觉编码模块先提取 Peach 图像中的特征,再由 Transformer 编码器建立视觉区域之间的关联。解码器利用视觉上下文,生成 Peach is wearing a black face mask and dark blue overalls.(Peach 戴着黑色口罩,穿着深蓝色背带裤。)。
通常 Transformer 采用多层编码器和多层解码器。每层通过注意力机制、前馈神经网络以及残差归一化结构处理特征。
输入 Token 化与嵌入
Tokenization and Embedding
Transformer 不能直接处理自然语言文字或原始图像,需要首先将输入转换为数值表示。
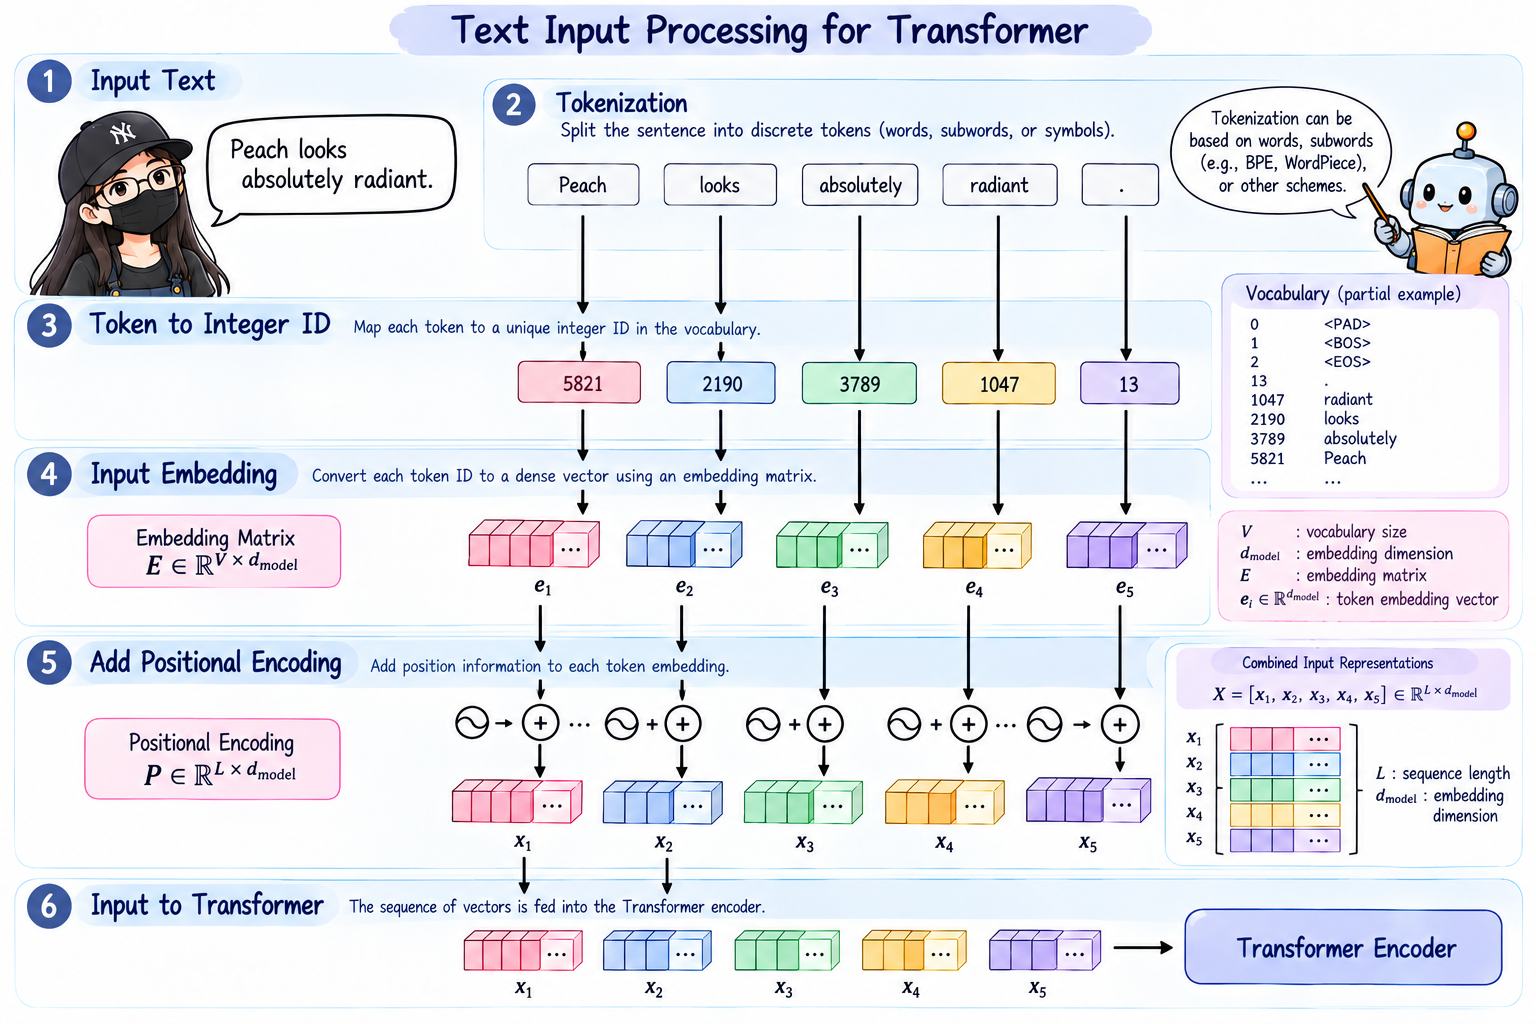
在文本翻译中,Tokenization 将英文句子拆分为 Token,例如:Peach、looks、absolutely、radiant和.
这些 Token 被转换为整数 ID,再通过输入嵌入层(Input Embedding)映射为固定维度的向量。实际模型可能采用子词切分,一个单词不一定只对应一个 Token。
在图像描述中,可以采用视觉 Transformer(Vision Transformer,ViT)等视觉编码方法,将 Peach 的图像划分为多个图像块(Image Patches),并通过线性投影转换为视觉 Token。也可以使用卷积神经网络(Convolutional Neural Network,CNN)等视觉编码器提取图像特征,再将其映射为 Transformer 输入。例如,部分视觉 Token 包含口罩区域的信息,另一些包含帽子、头发或背带裤的特征。每个 Token 对应的是学习得到的数值表示,而不是直接存储“口罩”这样的文字标签。
划重点:文本通过 Tokenization 和 Embedding 转换为向量,图像通过视觉编码转换为视觉特征,两者最终都形成 Transformer 可以处理的输入表示。
位置编码
Positional Encoding
输入嵌入提供内容特征,但自注意力机制本身并不自动知道 Token 的顺序或空间位置。
在文本翻译中,Peach looks absolutely radiant. 的词语顺序影响语法和语义。位置编码帮助模型区分 Peach 位于句首、absolutely 位于 radiant 之前等信息。
在图像描述中,空间位置同样重要。黑色口罩位于 Peach 的面部区域,而深蓝色背带裤位于身体区域。如果缺少空间位置信息,模型就难以充分理解这些视觉特征的布局关系。
经典 Transformer 使用正弦和余弦函数生成序列位置编码;视觉模型则可以采用二维位置编码或其他空间位置表示。
划重点:Embedding 表示信息的内容,Positional Encoding 表示信息所在的位置。
多头自注意力机制
Multi-Head Self-Attention
自注意力机制(Self-Attention)是 Transformer 的核心。它使每个 Token 能够根据相关性,从同一序列的其他 Token 中获取信息。
每个 Token 经过三个可学习的线性变换,生成:
- Query(Q,查询):我正在寻找什么信息?
- Key(K,键):我具有哪些可供匹配的特征?
- Value(V,值):如果其他 Token 关注我,我能够提供什么信息?
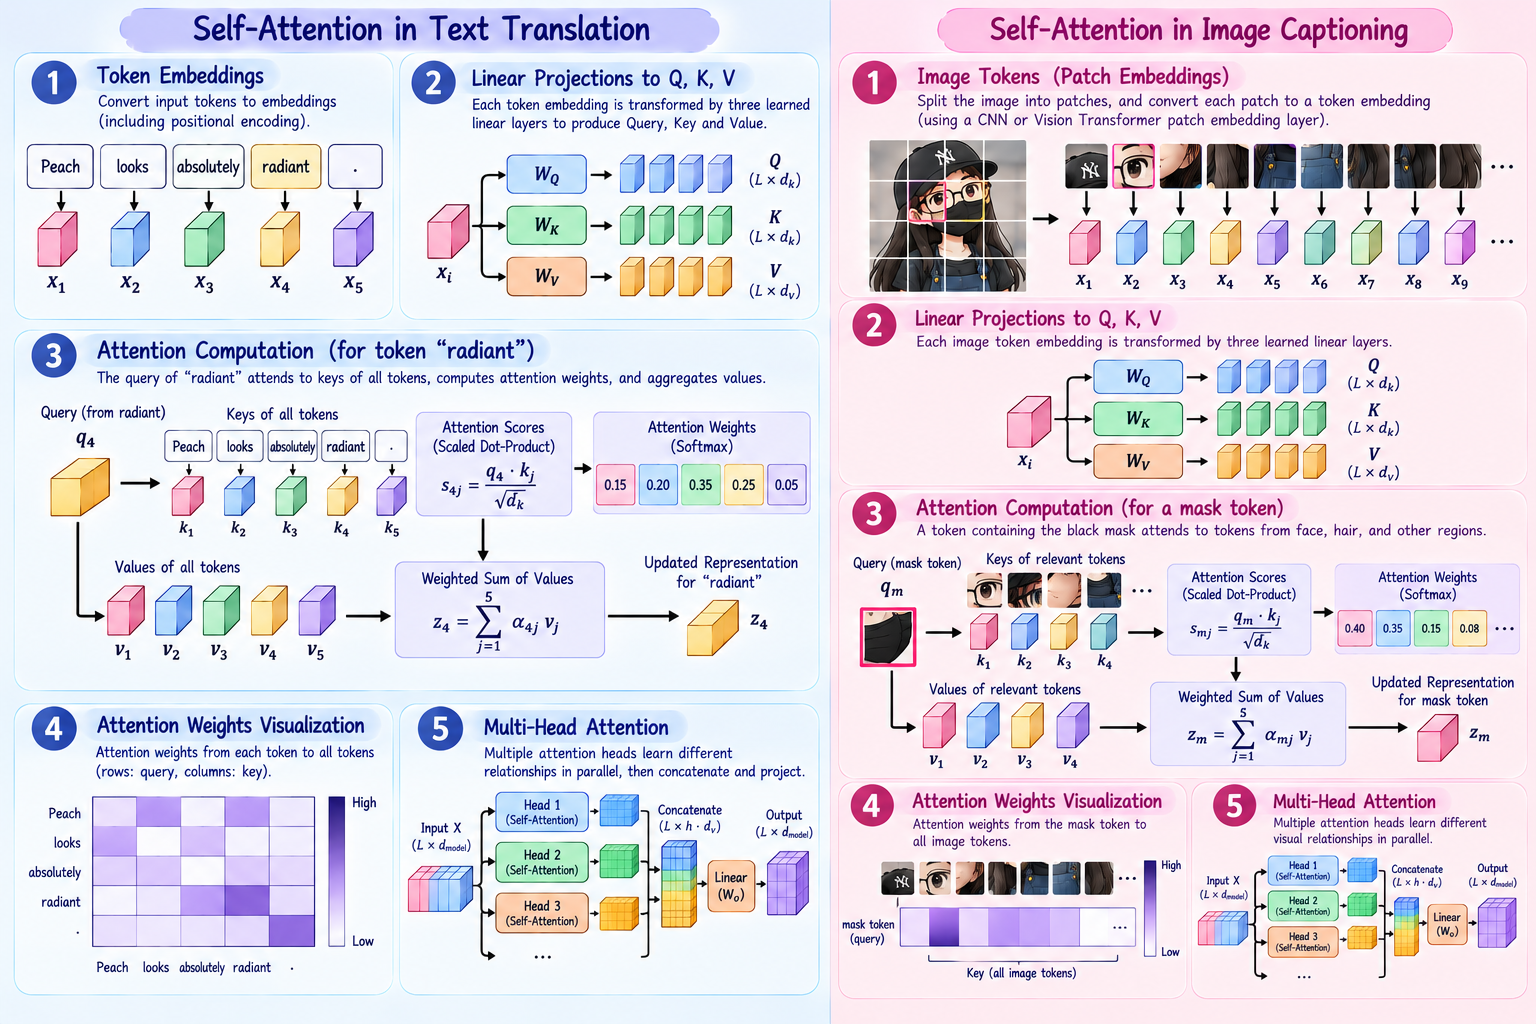
在文本翻译中,当模型处理 radiant 时,它的 Query 可以与 Peach、looks 和 absolutely 的 Key 进行匹配。模型根据匹配分数计算注意力权重,再对相应的 Value 加权聚合,使 radiant 的新表示融合相关上下文。
在图像描述中,假设某个视觉 Token 包含黑色口罩的特征,它可以与面部、头发和其他图像区域的 Token 建立关联。通过这种信息交互,模型能够学习口罩与人物面部之间的上下文关系。
多头注意力(Multi-Head Attention)进一步使用多个注意力头,在不同特征子空间中并行学习关系。
例如,文本中不同注意力头可能对词语修饰关系和句法关系表现出不同敏感性;图像中不同注意力头可能关注局部外观、空间布局或跨区域关联。
这些关系由训练自动学习,并非人为指定每个注意力头的固定功能。
划重点:Self-Attention 让 Token 交换上下文信息,Multi-Head Attention 使模型能够从不同特征角度学习关联。
残差连接与层归一化
Add and Norm
完成注意力计算后,Transformer 通过 Add and Norm 处理输出。
Add 对应残差连接(Residual Connection),将子层输入与输出相加;Norm 对应层归一化(Layer Normalization),对 Token 的特征进行归一化和可学习调整。
在文本翻译中,残差连接有助于保留原有词语特征,同时融合注意力计算得到的上下文信息。
在图像描述中,残差连接同样帮助保留视觉 Token 的原有特征,并与跨区域交互得到的新信息结合。
层归一化则帮助两种任务中的深层网络保持较稳定的训练过程。
原始 Transformer 采用先残差相加、再层归一化的 Post-LN 结构。
划重点:残差连接改善信息与梯度传播,层归一化帮助稳定网络训练。
前馈神经网络
Feed-Forward Network
自注意力(Self-Attention)负责不同 Token 之间的信息交互,而前馈神经网络(Feed-Forward Network,FFN)进一步对每个 Token 的特征进行非线性变换。
在文本翻译中,经过注意力计算的 radiant 已经融合了与其他词语相关的信息,FFN 进一步变换其特征表示。
在图像描述中,包含黑色口罩信息的视觉 Token 同样经过 FFN,使其特征能够进一步参与后续的视觉语义建模。
需要注意,FFN 通常独立作用于每个 Token 的特征维度,不直接执行 Token 之间的信息交换。
划重点:Self-Attention 负责信息关联,Feed Forward 负责特征的非线性变换。
编码器层堆叠
Encoder Stack
一个经典编码器层由多头自注意力、前馈神经网络及相应的 Add and Norm 组成。
Transformer 将多个编码器层连续堆叠,使每一层都能够在前一层的基础上进一步融合上下文信息。
在文本翻译中,Peach、looks、absolutely 和 radiant 的表示经过多层处理,逐步形成包含整个句子上下文的特征。
在图像描述中,帽子、黑色口罩、眼镜和深蓝色背带裤等视觉区域的特征也通过多层注意力交互,形成包含整体图像上下文的表示。
最终,编码器输出一组上下文特征,供解码器使用。
划重点:编码器通过多层注意力与特征变换,将局部 Token 表示逐步转化为包含上下文信息的表示。
解码器与因果掩码
Decoder and Causal Masking
编码器完成输入理解后,解码器开始生成目标序列。
训练时,正确目标序列经过右移(Shifted Right)后输入解码器,并通过因果掩码(Causal Mask)阻止当前位置访问未来目标 Token。
在文本翻译中,目标句子为:Peach 看起来光彩照人。当模型预测“光彩照人”时,可以利用此前的 Peach 和“看起来”,但不能提前读取当前需要预测的正确答案。
在图像描述中,目标句子为:Peach is wearing a black face mask and dark blue overalls. 当模型准备预测 mask 时,可以利用此前的 Peach is wearing a black face,但不能提前访问后面的 mask 或 overalls 等目标 Token。
不过,解码器仍然可以通过交叉注意力访问完整的编码器输出,包括完整英文源句或完整图像的编码特征。
划重点:因果掩码限制未来目标 Token 的访问,使解码器能够学习逐步生成输出。
编码器—解码器交叉注意力
Cross-Attention
解码器不仅需要参考已经生成的内容,还需要获取编码器提供的输入信息。
因此,经典 Transformer 引入交叉注意力(Cross-Attention)。
其中,Query 来自解码器当前隐藏表示,Key 和 Value 来自编码器的最终输出。
在文本翻译中,当解码器准备生成“光彩照人”时,可以利用 Query 从英文编码表示中聚合与 radiant、absolutely 及其上下文有关的信息。
在图像描述中,当解码器准备生成 black face mask 时,可以利用 Query 从视觉编码表示中聚合与口罩区域及其上下文相关的视觉信息。
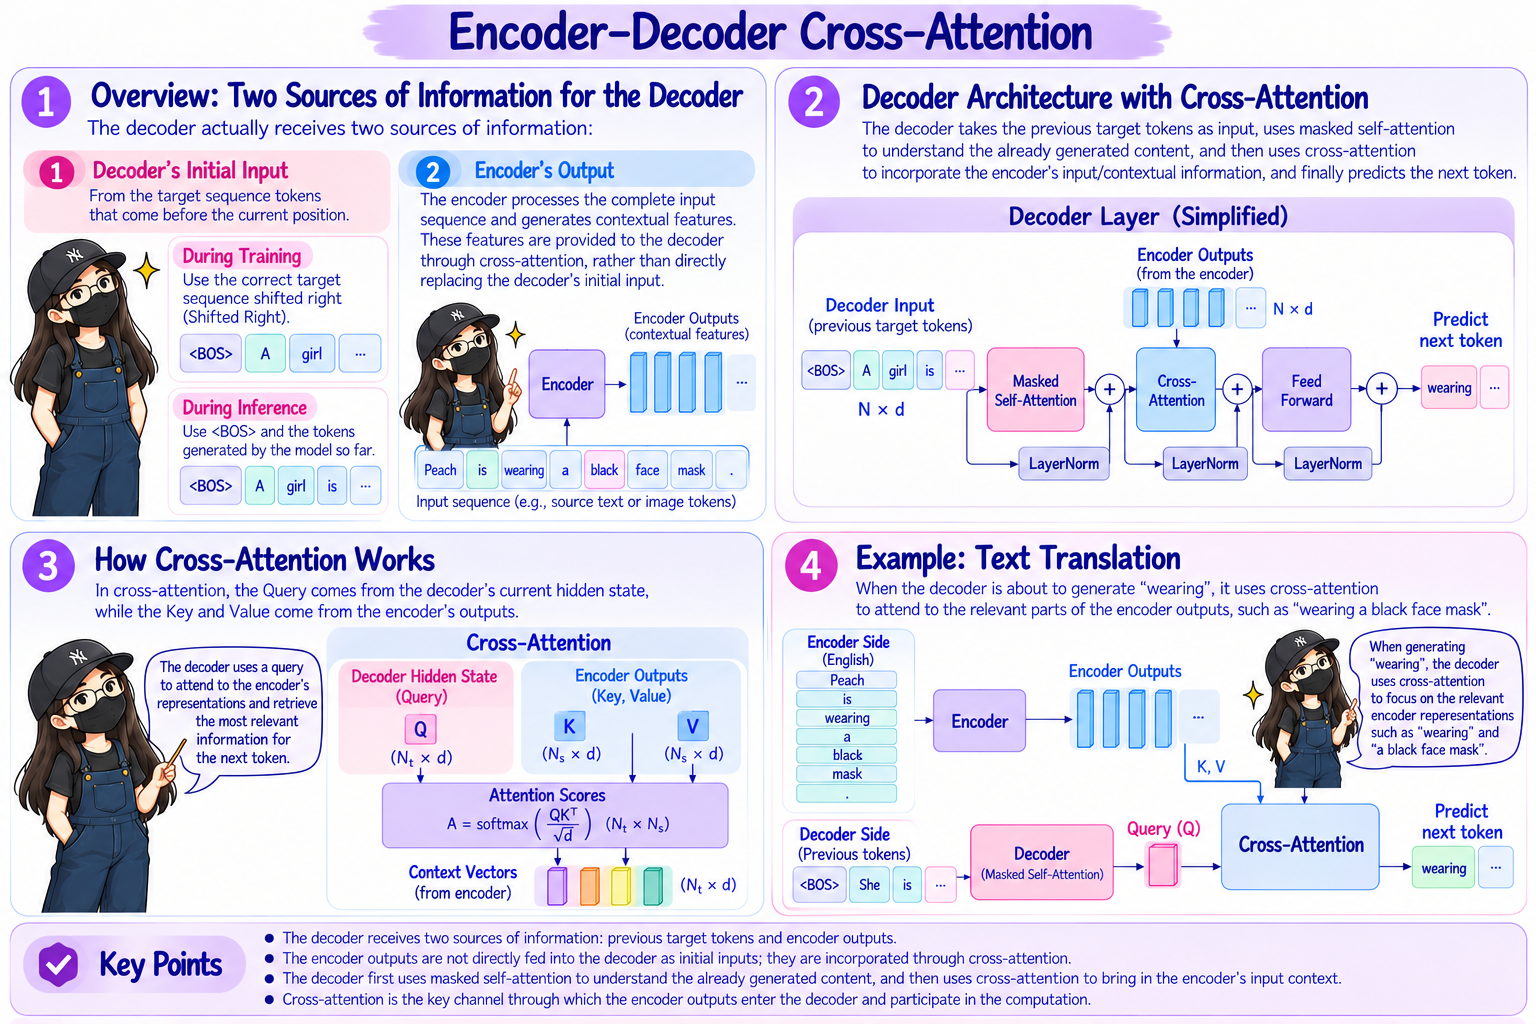
Decoder 实际上接收两路信息:
第一路:Decoder 的初始输入
来自目标序列中此前的 Token。
训练时:使用右移后的正确目标序列(Shifted Right)。
推理时:使用 BOS 和此前由模型生成的 Token。
第二路:Encoder 的输出
Encoder 对完整输入序列进行编码,生成上下文特征。这些特征通过 Cross-Attention 提供给 Decoder,而不是直接替代 Decoder 的初始输入。
Decoder 以此前的目标 Token 为初始输入,通过 Masked Self-Attention 理解已经生成的内容,再通过 Cross-Attention 引入 Encoder 的输入上下文信息,最后预测下一个 Token。
换句话说,Encoder 的输出不是先进入 Decoder、然后又被重复融合一次;Cross-Attention 本身就是 Encoder 输出进入 Decoder 并参与计算的关键通道。
划重点:Self-Attention 建立同一序列内部的关系,Cross-Attention 建立输出序列与输入序列之间的关系。
输出预测
Linear and Softmax
经过解码器处理后,模型得到当前目标位置的隐藏特征。
线性层(Linear Layer)将这些特征映射为目标词表中各候选 Token 的分数(Logits),Softmax 则将分数转换为概率分布。
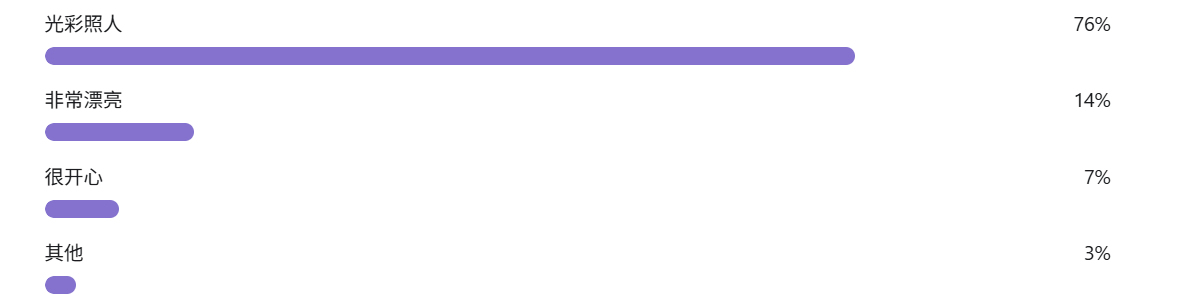
在文本翻译中,模型可能根据 Peach 看起来 预测“光彩照人”。假设下一个 Token 概率分布:
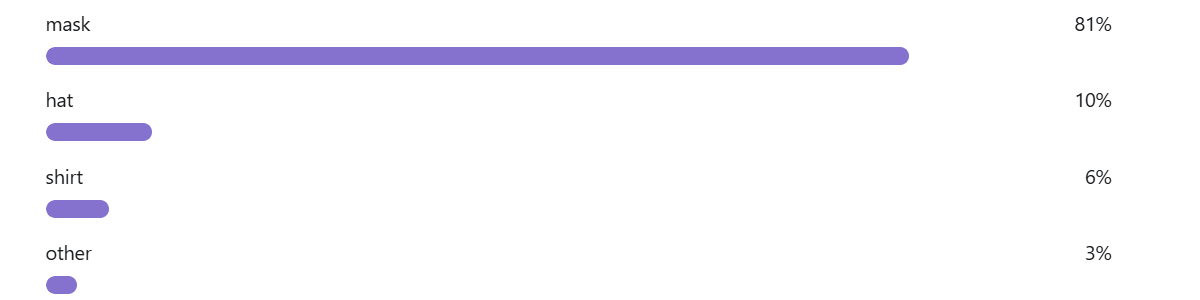
在图像描述中,模型可能根据 Peach is wearing a black face 预测 mask。假设下一个 Token 概率分布:
模型根据概率分布选择后续 Token,并持续生成,直到输出结束符。
划重点:Linear 计算候选 Token 的分数,Softmax 将其转换为预测概率。
模型训练
Model Training
Transformer 的嵌入向量、注意力投影和前馈网络参数,都需要通过训练学习。
在文本翻译中,训练数据由英文句子及其对应的中文翻译组成。例如,模型学习从 Peach looks absolutely radiant. 生成“ Peach 看起来光彩照人。 ”
在图像描述中,训练数据由图像及其对应的描述文本组成。例如,模型学习根据 Peach 戴黑色口罩、穿深蓝色背带裤的图像,生成相应的英文描述。
训练时,模型在因果掩码约束下预测目标 Token,并使用交叉熵损失(Cross-Entropy Loss)衡量预测概率与正确答案之间的差异。
随后,通过反向传播(Backpropagation)计算梯度,再由优化器更新网络参数。
两种任务的训练目标相似,都是学习在输入上下文和此前目标 Token 的条件下,预测下一个目标 Token。
划重点:通过正确示例与预测误差,不断优化模型参数,使其学习输入与目标序列之间的映射关系。
模型推理
Inference
完成训练后,Transformer 可以对新的输入生成结果。
在文本翻译中,编码器首先处理完整英文句子,解码器从起始 Token 开始,逐步生成中文。
在图像描述中,视觉编码模块首先处理 Peach 的图像,解码器利用视觉上下文,逐步生成英文描述。
训练时,模型可以使用右移后的正确目标序列并行计算多个位置的预测损失;推理时,则需要根据此前实际生成的 Token 逐步预测。
划重点:训练让模型学习预测规律,推理则利用已学习的规律生成新的序列。
优势与局限
Advantages and Limitations
Transformer 的主要优势在于通过注意力机制建立信息之间的直接联系,并在训练阶段有效利用并行计算。
在文本翻译中,这使模型能够学习相距较远的词语之间的依赖关系,并结合上下文生成自然译文。
在图像描述中,视觉 Token 之间的注意力交互有助于模型关联不同图像区域,再通过交叉注意力将视觉信息用于文字生成。

但标准全注意力机制的计算量和注意力矩阵存储开销通常随序列长度呈平方增长。例如,较长的文本序列会增加注意力计算成本;高分辨率图像如果被划分为大量视觉 Token,也可能显著增加计算负担。
此外,两种任务采用自回归解码时,生成过程通常需要逐 Token 进行,因此输出长度也会影响推理延迟。
划重点:Transformer 具有强大的上下文建模能力,但需要在模型规模、Token 数量与计算效率之间取得平衡。
现在回顾整个 Transformer 的工作过程。
对于文本翻译,模型将 Peach looks absolutely radiant. 转换为 Token 向量,利用编码器理解词语之间的关系,再由解码器生成“ Peach 看起来光彩照人。 ”
对于图像描述,模型将 Peach 的全身图像转换为视觉 Token,利用编码器建立帽子、口罩、眼镜和背带裤等区域之间的上下文关系,再由解码器生成 Peach is wearing a black face mask and dark blue overalls.
两种任务虽然输入不同,但遵循相似的计算逻辑:
输入编码 → 位置表示 → 自注意力 → 上下文特征 → 交叉注意力 → 自回归输出。
Transformer 的核心理念,是利用注意力机制建立信息之间的依赖关系,通过多层神经网络学习上下文表示,再根据这些表示完成序列预测。
从文本翻译到图像描述,Transformer 展示了将不同类型的信息转换为特征表示,并通过统一的注意力机制进行建模的能力。这也为后续研究语言、视觉与动作相结合的机器人学习模型奠定了基础。